Träna AI på egna dokument eller låta den läsa dem?
Många vill ha en AI som kan organisationens rutiner, avtal och manualer. Ofta är tanken att träna en modell på dokumenten. Det finns också ett annat sätt, där modellen läser rätt dokument varje gång någon frågar.
 iSearch
Innehåll
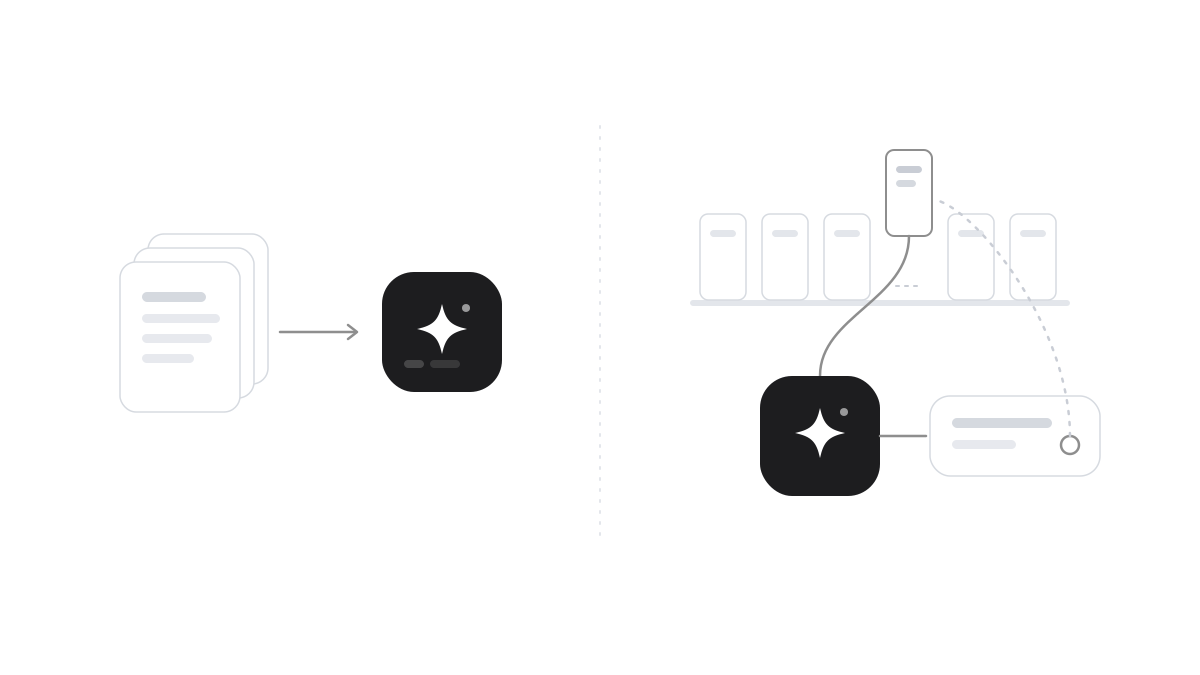
Frågan kommer tidigt i nästan varje samtal om AI i en organisation. Kan vi träna en AI på våra egna dokument, så att den kan svara på det som gäller hos oss? Svaret är ja, men det är sällan det bästa sättet att nå målet. Ofta ger det bättre resultat att låta modellen vara som den är och i stället ge den rätt dokument att läsa när frågan ställs. Valet påverkar hur aktuella svaren blir, om de går att kontrollera och vem som får se vad.
Att träna modellen eller låta den läsa
Vid finjustering tränas en befintlig språkmodell vidare på ett eget material. Modellen ändras, och det den har lärt sig finns sedan inbyggt i den. Metoden passar för att lära en modell en ton, ett format eller en avgränsad uppgift som återkommer.
Med RAG, retrieval-augmented generation, lämnas modellen orörd. När någon ställer en fråga söker systemet först fram de stycken i era dokument som bäst svarar på den. Modellen får läsa dem och formulerar svaret utifrån det. Metoden beskrevs av forskare 2020, med just målet att ge språkmodeller tillgång till kunskap som går att uppdatera och spåra.
Aktuella svar med källor
En finjusterad modell vet det som stod i materialet när den tränades. När en rutin ändras lever den gamla versionen kvar i modellen tills den tränas om. Med RAG läser modellen det dokument som gäller i dag. Ett nytt dokument kan användas så snart det har lagts in, och ett dokument som tas bort påverkar inte längre svaren.
Källorna skiljer också metoderna åt. En tränad modell kan sällan visa var en viss uppgift kommer ifrån, eftersom kunskapen har gått upp i modellen. När svaret bygger på dokument som har lästs in kan det visa vilka de är. Den som läser svaret kan öppna källan och kontrollera, och risken att modellen hittar på minskar när svaret har ett underlag att stå på.
Behörigheter och personuppgifter
I en organisation får inte alla läsa allt. Med RAG kan sökningen följa samma behörigheter som i övriga system, så att varje person bara får svar ur de dokument hen har rätt att se. En modell som har tränats på allt material kan inte hålla isär det på samma sätt. Det den har lärt sig kan i princip komma fram i svaret till vem som helst.
Personuppgifter gör frågan viktigare. Forskning har visat att språkmodeller kan återge delar av det de har tränats på, ibland ordagrant. Europeiska dataskyddsstyrelsen konstaterade i december 2024 att en AI-modell som har tränats på personuppgifter inte i alla lägen kan betraktas som anonym. Att få bort en enskild uppgift ur en tränad modell är svårt. När modellen läser dokumenten räcker det att ändra eller ta bort dokumentet.
Finjustering har ändå sin plats. Den kan ge en modell ett fackspråk, en fast struktur för svaren eller bättre träffsäkerhet i en snäv uppgift, och metoderna går att kombinera. För frågor om vad som gäller hos er är det läsningen av era dokument som ger svaret dess underlag.
Så fungerar det i iSearch
Assistenterna i iSearch svarar ur era egna kunskapsbanker och visar vilka dokument som lästes. Era frågor och dokument används aldrig för att träna modeller. Rollbaserad åtkomst styr vem som når vad, så att svaren bara bygger på det användaren har rätt att se. Varje kund får en egen, separat installation, och hela kedjan kan köras i er egen miljö.
Läs mer om hur ni undviker att AI hittar på och behörigheter i AI, eller boka en genomgång.
Källor: Lewis m.fl., Retrieval-Augmented Generation (2020)Carlini m.fl., Extracting Training Data from Large Language Models (2020)EDPB, yttrande 28/2024 om AI-modeller (2024)